Programación multi-agentica

Amigos !, como siempre, no vengo a hablar por hablar, saben bien que no voy a publicar artículos que no aporten algo de valor a sus conocimientos.

La era de IA llegó, y realmente lo cambio todo. <– buen titular no ? jaja lo veo en todos lados, pero nadie explica ni cuenta (a excepción de algunos pocos casos) lo que realmente sirve. Veo varias piezas del rompecabezas desperdigadas, y como siempre me pasó, hay que armar el rompe cabezas y ahi sale este articulo…

hoy por hoy, podes delegar la escritura de código en un agente de IA (un agente de IA es, básicamente hablando, como el chatgpt, pero con acceso a ejecutar comandos en tu computadora, ese agente puede interactuar con tu computadora, entonces deja de quedar en el clásico mensaje de la IA diciéndote «en tu caso haría tal cosa u ejecutaría tal otra» y pasa mas bien a ejecutar la misma IA eso que vía chat te mandaba a hacer a vos). Ese agente de IA lo podes acceder vía algún producto pensado para ello: claude code, opencode, codex, antigravity pi, etc

Introduccion:

Primeros usos:

Ahora bien, cada uno tiene lo suyo, si querés usarlo bien, tenes que pagar algún proveedor de IA que te permita tener acceso a modelos de Ios potentes. Si querés probar su uso nada mas, tipo que querés «ver que onda», la opción es opencode (te trae modelos chinos gratuitos que te dejan usarlos, rotando entre algunos que ellos te dan diariamente, no esperes maravillas, pero al menos te dan una aproximación a lo que seria un modelo «pago»)

A todo esto, no hablamos de «como utilizar» la IA correctamente. Este tema / apartado es súper interesante, porque tiene varias «aristas» por las que te podes ir y profundizar hasta perderte. Hagamos un indice de posibles caminos por los que podrías incursionar:

  1. entrenar un modelo de Ia vos mismo (caro, requiere un objetivo claro, y mucho tiempo de dedicacion y estudio previo)
  2. ejecutar un modelo de Ia en tu local (hoy por hoy, no tiene sentido, para ejecutar deepSeek v4 flash necesitas 128 GB de vRAM <– no es la RAM convencional)
  3. probar varios modelos de IA de varios proveedores y/o balancear entre varios o incluso usar cosas como openRouter (esto en opencode podrias hacerlo sin problema)
  4. usar via api una IA para montar encima de esa IA un sistema transaccional y todo lo que conlleva tener el uso de la en tus sistemas transaccionales (aca no tenes limite de uso, solo que es mas caro por tokens y es mas bien para darle «inteligencia» a un sistema donde estes desarrollando vos como programador)
  5. implementar harness para poder programar con IA (Esto esta bueno para cuando no queres usar «cajas negras» sin entender que pasa por debajo, me pasó eso, y terminé creando el mio propio, un Meta-harness en realidad)
  6. usar un CLI de algún provider y programar directo sobre el sin hacer nada (mala idea, porque esos productos como claude, opencode, codex, y ahora antigravity con gemini v4, estan hechos para funcionar pero buscando un fin comercial)
  7. utilizar un harness sobre un cli para programación agéntica: (Aca esta la papa diriamos en argentina, este punto es en el mas me voy a meter en este articulo, porque fue el que mas desarrolle y termine teniendo el mio propio como decia mas arriba… este punto se le conoce como meta-harness, porque la cli es un harness, y nuestro meta-harness se monta encima del cli para darle mas pautas y features necesarias para que sea mas rendidor, no alucine, y recuerde todo)

  1. ¿Que aspectos debo tener en cuenta?

Los puntos 5 y 6 se relacionan y mucho.

lo mas facil para arrancar con la programación multi-agéntica es utilizar un cli de algún provider (punto 6). simplemente te descargas opencode y comenzas a utilizar «la IA» para que comience a escribir codigo por vos, lo mismo con claudecode cli (hablo mucho de cli porque son los que mas conozco, se ejecutan en la terminal).
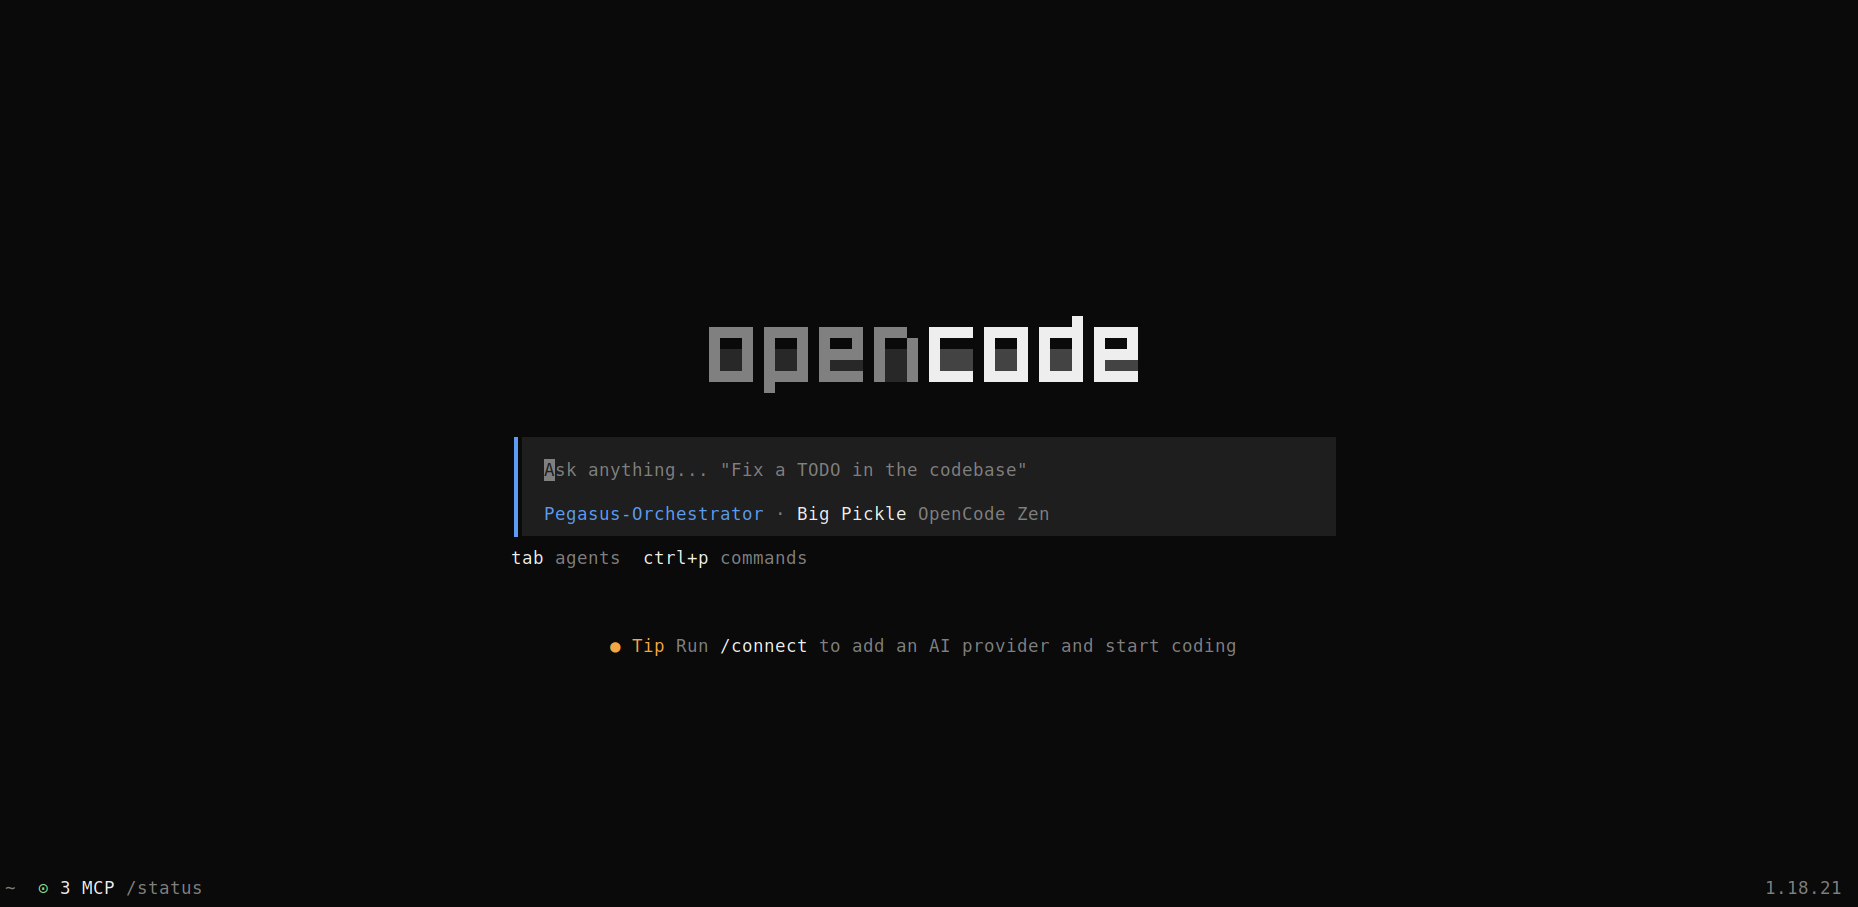
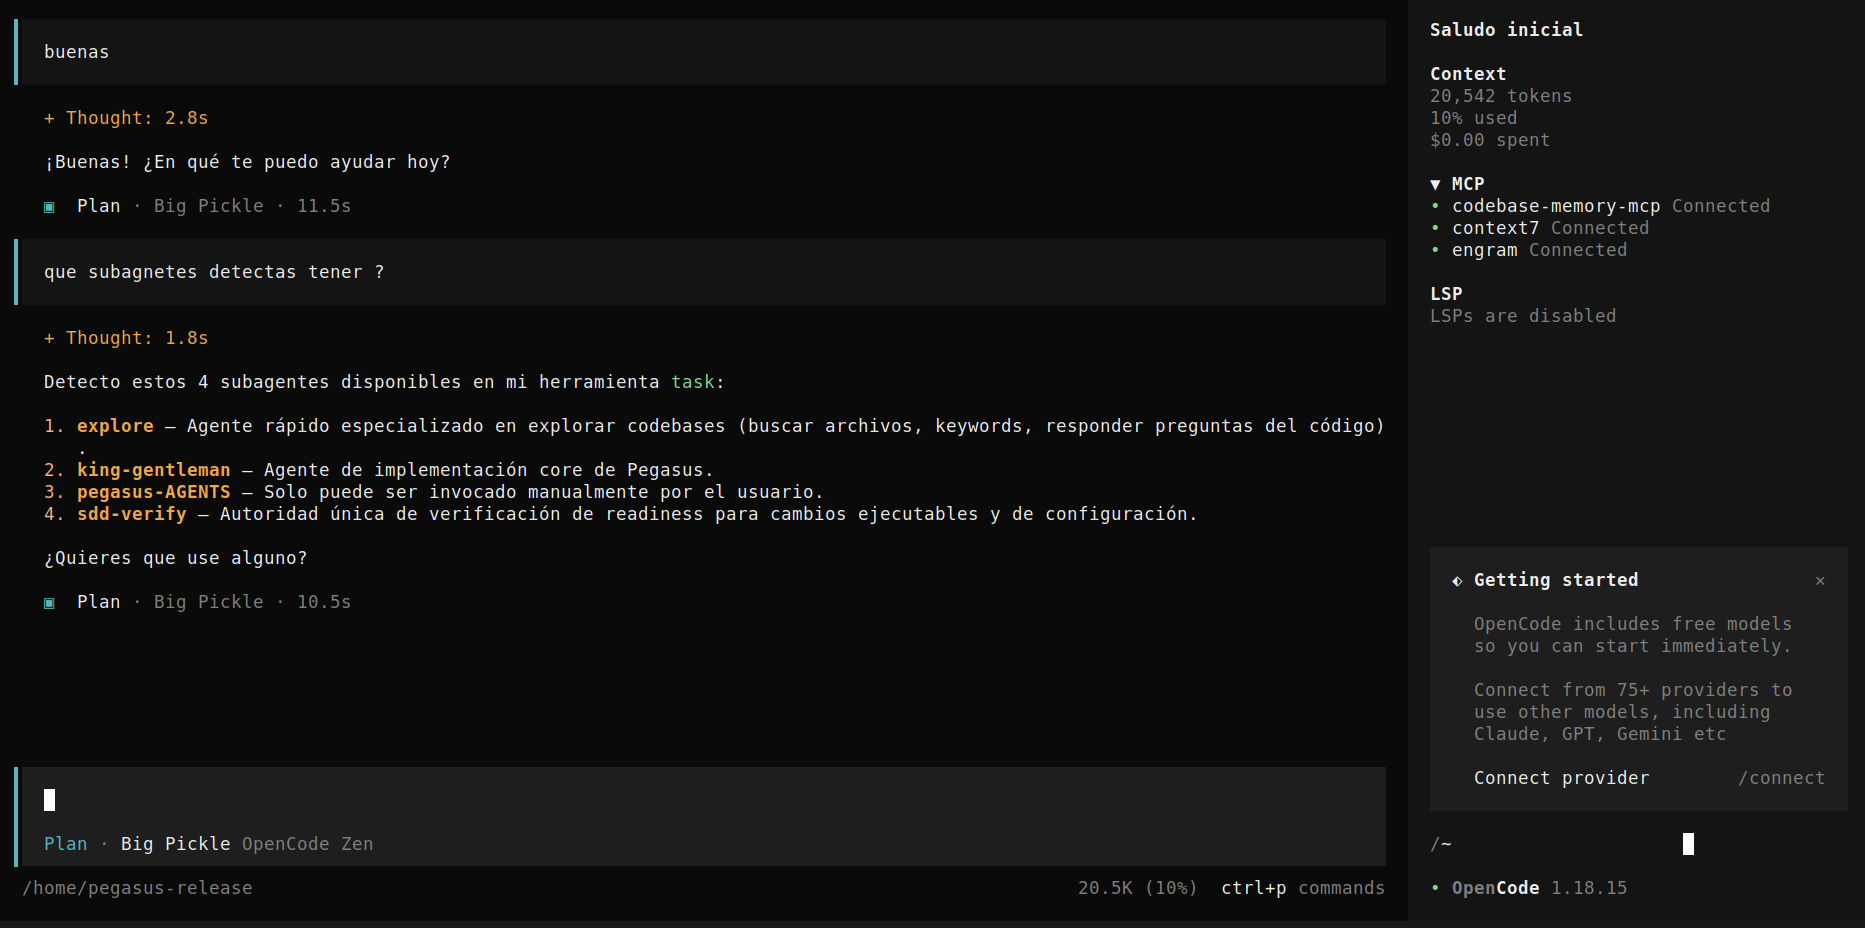
con ClaudeCode podes usarlo pero muy restringido porque tenes que pagar para su uso, y te deja muy poco, ademas de que luego de usarlo un tiempito te dice que esperes 5 horas para continuar, opencode en cambio te deja usarlo con modelos gratuitos chinos sin problema (no esperes maravillas pero para empezar esta bien)

Ahora bien, en Claude si pagas la suscripcion tenes algo que se llama Ultracode que te cobran un monton pero aplican patrones de uso de agentes que te sirven y mucho.

Ahora vamos dar definiciones / conceptos necesarios para avanzar:

1.- que es un agente? ya lo definimos, como el chatgpt, pero puede leer tus archivos y ejecutar escrituras sobre ellos y ejecutar comandos en tu maquina

2.- que es ventana de contexto: Toda ia que quieras usar como agentes, tienen una ventana de contexto, que en realidad es cuando memoria RAM te dejan usar en tu session en los servidores de IA donde estas utilizando. Como toda RAM (y por eso es tan cara porque los providers de IA estan acaparando todo el mercado en comprar RAM y mas RAM), como decia toda RAM tiene su limite, es decir, vos no tenes disponible memoria RAM infinita para utilizar en los servidores de IA para TU session, y mas considerando que otros quieren tambien ejecutar su session propia… imaginense la cantidad que se necesita para cumplir con la demanda!

3.- que se guarda en la ventana de contexto y para que sirve? bueno todo lo que hables con la IA se tiene que guardar temporalmente en algun lado. La IA tiene que recorrer toda es conversacion para poder responderte sobre lo que estan hablando. Y como sabras, esa conversacion de ida y vuelta va creciendo con el tiempo, y en algun momento tu conversacion (incluso los archivos que leyo la IA de tu maquina) se guardan alli. Con lo cual, en algun punto tu memoria RAM asignada en tu session se llena. En ese punto, que hacemos? bueno la solucion que implementaron Clis como opencode y claude, es … veo que estas por llenar la ventana de contexto…. bueno… pummm se dispone a «compactar» ese contenido que hay alli y solo deja un resumen… <– problema aqui: perdes informacion de la conversacion !

4.- Que es IA alucinaciones? bueno aca, la ia no es que alucina, mas bien (por como funciona) siempre «completa» la conversacion, en donde no sabe un dato, lo completa con la informacion mas probable que se pueda tener alli, y si tu contexto «compactó» y tenes huecos de informacion, la ia lo va a completar con informacion «probable», ahi viene la famosa alucinacion.

Bien! para que sirve saber todo esto ? bueno mas bien, entender donde estamos parados cuando usamos la IA con programacion agentica sobre una cli, tenemos que saber como funciona, o por lo menos minimamente que cosas debemos saber para atacar los problemas que lleva usar la IA.

Como se usa la IA para programacion multiagentica en una CLI ?

bueno aca como dijimos al ppio, es mas bien de comenzar por algun sitio. El camino es usar opencode o claude o codex o antigravity, sin nada mas

Ahora bien, para la utilizacion de una CLI, existen varios artefactos que se le pueden aplicar para que la ventana de contexto no explote, y para que tu gasto (si tenes una subscripcion) no se termine enseguida.

Artefactos:

System-Prompt: le dice a todos tus agentes (toda CLI ya viene con uno de fabrica) como comportarse y no lo podes modificar ! (aca aparece un cli muy «vacio» llamado pi, muy bueno si te queres meter hasta incluso redefinir el system prompt)

Agentes y sub-agentes: toda CLI viene por lo menos un agente, opencode viene con un build (construccion) y otro de plan, claude viene con un principal y otro (de menor modelo) para trabajo general, etc <– aca esta uno de los puntos a mejorar desde un meta-harness: crear tus propios agentes (cada uno con un rol y skill y tools asociadas)

SKills, comportamiento que podes cargarle a un agente de tu opencode en el momento que quieras con un «comando» (un comando lo podes crear tambien como un artefacto dentro de tu opencode) y ese comando le inyecta instrucciones a tu agente (skill) o dentro de un mismo agente podes invocar la skill

Flujo de trabajo: Acá es donde comenzó todo este tema en mi incursion en todo esto. Inicialmente comencé curioso de armar mi propio flujo de trabajo, mis agentes, mis skills, comandos, etcs. Los que explicaban esto, te mostraban lo mismo que les comento yo hasta ahora, te mostraban los elementos por separado las posibildiades que habia, pero nada mas… Hay mucho de esto hoy en dia… pero nadie te muestra como seria ese armado, lo que vi en este tema, es que aparecieron unos pocos con algo ya armado y te lo explicaban desde lo que hicieron ellos, y te promocionaban que usaras lo que ellos armaron… Cuando vi eso, dije «Pero no me dejas aprender a armar el mio !», asi que me dispuse a aprender de lo que ya tenian armado ellos, y por suerte opencode te permite aprender de lo que ellos le meten como «meta-harness».

Hacia un meta-harness propio:

Bien, ya tenemos los elementos, los clis, los conceptos. Vamos a establecer las pautas que tenes que saber para armar tu propio meta-harness:

Patron Orquestador Minion:

Primero tenes que saber que un meta-harness lo podes armar «artesanalmente», por ejemplo en opencode, en el opencode.json, podes definir tu agentes:
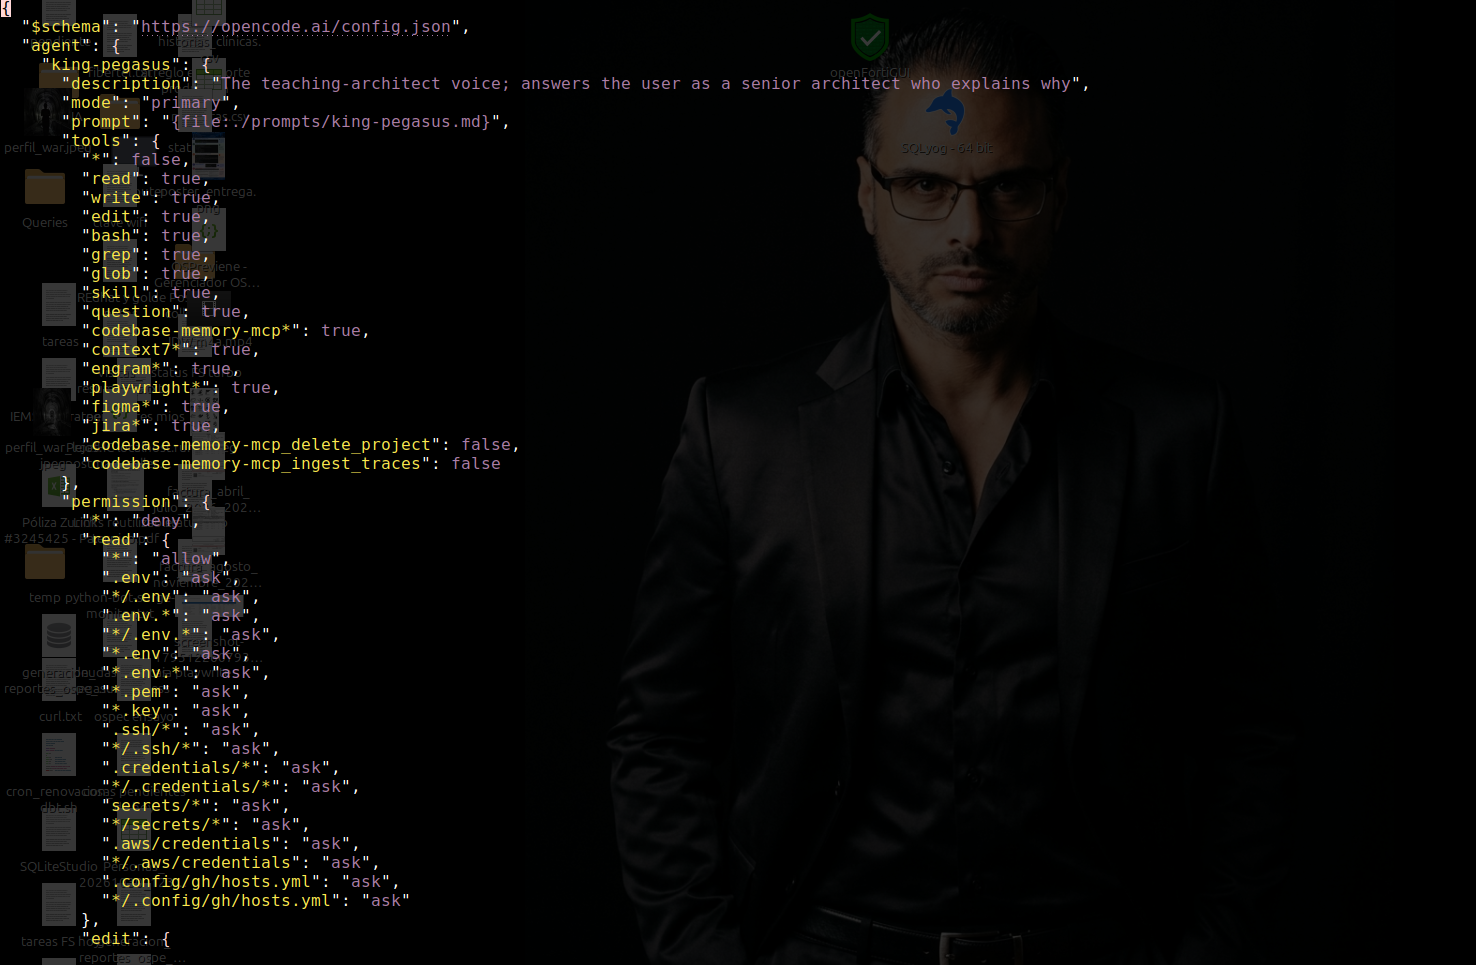
pero no solo es eso, tenes que pensar en como seria un equipo de agentes que te cuadren a vos en un flujo de trabajo que te sirva para el trabajo de desarrollo que van a encarar.

Mi propio flujo: Te cuento mi flujo que termine implementado, tengo patron de anthropic que define el patron orquestador minion
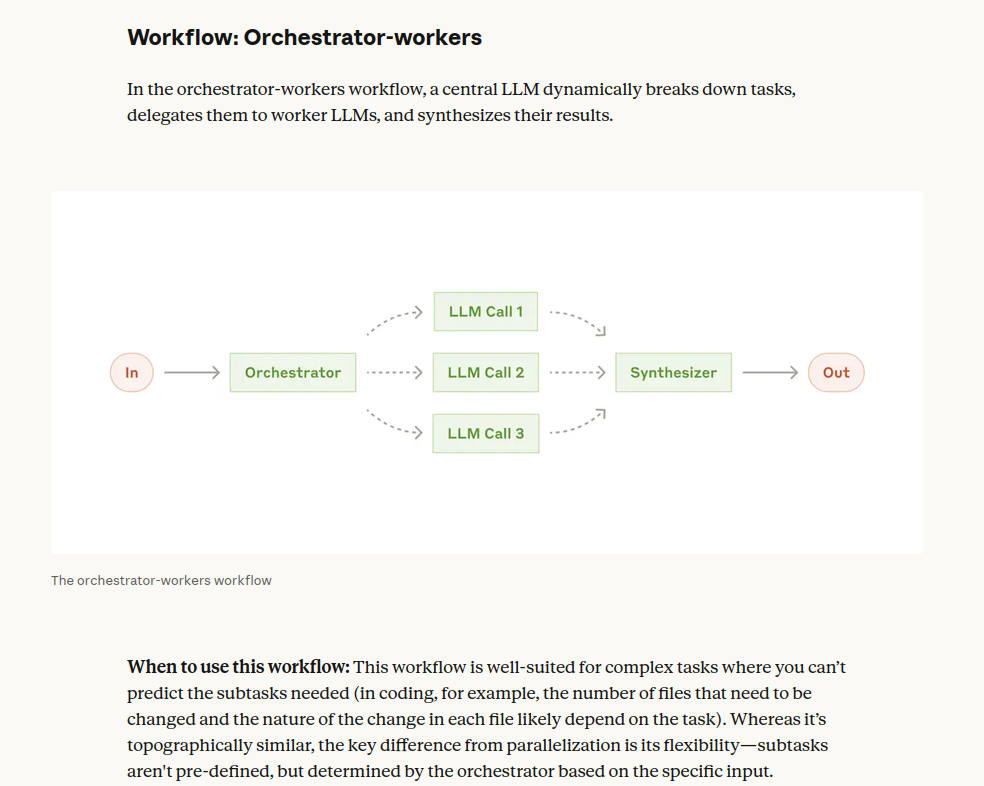
https://www.anthropic.com/research/building-effective-agents

Con eso tenes de los patrones que mejor podes implementar en un meta-harness

Patron implementador – verificador

Luego tenes que definir ademas del orquestador y sus «workers», una dinamica de «implemento-verifico», como sabrás en desarrollo, el que desarrolla no verifica, con los agentes es lo mismo, tenes que tener uno que se dedique a desarrollar (yo lo llamo implementador) y otro que verifique el trabajo de lo que hizo el implementador

Worker General

Tambien tenes que meter ahi uno que sea para tareas generales (General Worker)

Coordinar todo: Aca tenes que meterte con el prompt del orquestador que definiste, porque ahi tenes que definir en que casos usas un worker general y en que casos usas un implementador que necesariamente necesitas decir que luego del implementador, viene el verificador de eso.

Otras pautas para el orquestador:

Hacer que delegue nada mas, vas a notar que es lento y burocratico cuando la tarea es directa y sencilla (esto tambien fue el motivo por el que murio utilizar SDD), pero incluso sin SDD, tener la delegacion unicamente es un problema, asi que ahi tenes que definir tambien que el orquestador pueda hacer trabajos directamente, en vez de delegar absolutamente todo

En este punto te preguntarás: pero este pegasusOnline me explica como seria el flujo de agentes (que otros ya lo explican), pero no me dice como resolver cosas de diseño de meta-harness que son el motivo por el cual tiene sentido armar uno.

Tenés razón !, vamos con esos puntos:

1.- ventana de contexto

2.- memoria entre sesiones

3.- como te enteras de que cuando dejas un trabajo haciendose que te preguntaron algo o termino el trabajo ??

4.- como hago para que pruebe/compruebe tambien la GUI del usuario ? (sistema web?)

5.- como hago para ahorrar tokens en la busqueda / buceo en el codigo que quiero que revise??

6.- como hago para que consulte la ultima version del lengueje de programacion ??

Vamos con las respuestas:

1.- Ventana de contexto:

2 cosas tenes que saber:

a. la primera: ventana de contexto mas del 60% compacta!, pero antes hace que guarde todo el progreso porque retomar luego de compactar

b. la segunda: nunca dejes de cuidar que la cache que usan los proveedores de IA se pierda por meter un dato variable al ppio del system prompt

2.- memoria entre sesiones:

Aca tenes que implementar una forma de memoria entre sesiones, he visto varias formas de implementar esto: una es con un mcp en local con una base de datos sqlLite + fts5, otros con una db postgresql en un servidor central en un vps, otros con grafos de archivos .md. Basicamente tenes que armar una base de datos que centralice las memorias de cada decisión que tome el agente y permitirselo via MCP

3.- como te enteras de que cuando dejas un trabajo haciendose que te preguntaron algo o termino el trabajo ??

Aca lo que tenes que hacer es implementar en cada cli un plugin que intervenga en el flujo de trabajo y te arme una notificacion de cuando el agente requiere tu ayuda. Hay herramientas como Herdr terminal, que te lo trae nativo y resuelto

4.- como hago para que pruebe/compruebe tambien la GUI del usuario ? (sistema web?)

tenes que meter en cada cli el MCP de playwrite (solo sirve para navegador web, pero hay otros nativos para andriod y iphone)

5.- como hago para ahorrar tokens en la busqueda / buceo en el codigo que quiero que revise??

tenes que implementar en cada cli el MCP de memory-codebase-memory o similiar

6.- como hago para que consulte la ultima version del lengueje de programacion ??

metele el mcp de context7

Con todo esto, ya tenes los elementos y los conceptos para armar tu propio harness. Una cosa mas, vas a notar que se podria automaticar la instalacion en cada cli, creado un instalador, eso es justamente lo que hice, crear un instalador que detecte el o los clis y meterle el meta-harness que creaste

Desarrollo con POO + principios SOLID

La idea de SOLID es que crees una estructura de clases que sea mantenible en el tiempo y extensible en el tiempo.

S <– toda clase debería tener una sola responsabilidad

O <– toda entidad debería estar abierta a la extensión pero cerrada a la modificación. Cuando extendés la funcionalidad implica que lo que ya hacías se sigue manteniendo, pero le agregas comportamiento, no le quitas comportamiento ni le modificas comportamiento

L <– Principio de sustitución de Liskov (acá me aclaró mucho el comentario de Lucas), Las clases hijas deben poder sustituir a su clase padre. Es decir si alguien esta usando a tu clase padre, en vez de una instancia de tu clase padre te pasan a vos, vos deberías poder cumplir con las tareas que hace tu clase padre (por algo heredas de esa clase). Esto te permite pensar siempre que haces herencia, la herencia sea coherente.

I <– Segregación de interfaces, siempre interponer interfaces especificas a cada cliente tuyo en vez de una general para todo el mundo así evitas que todos implementen métodos innecesarios y no aplicables a todo el mundo.

D <– Inversión de dependencias (acá también iluminó Lucas). Básicamente lo que dice es que cuando tenes objetos que dependen de vos, no dependan directamente de vos, sino que entre ambos haya una interfaz siempre, de esa manera, el objeto dependiente de vos se puede cambiar por otro sin afectarte como clase (total ambos deben respetar la interfaz)

Evolución del desarrollo de sofware

Hace mucho que no escribo, en este mi espacio de divulgar información al mundo. Suelo escribir solo cuando algo me complicó, o me ayudo mucho o que me sorprende en algo. Ultimamente no me estaba pasando nada dificil de resolver o interesante. Y ustedes saben que no voy a escribir por escribir, no va de eso el espiritu de este espacio.

Bien!, al fin ocurrió algo que me resultó interesante y que me ayudó (sabiendo lo que implica esa ayuda)

ahora llegó la hora de usar la inteligencia artificial a mis propositos.

Siempre suelo ejecutar una serie de pasos ( click aqui ) para actualizar mi servidor de nextcloud que lo vengo manteniendo para tener mi propio google drive pero que solo yo lo tenga y disponible en cualquier lugar donde vaya.

Hace mucho que vengo con la idea de armar un script que me permita automatizar esa tarea, hace tiempo que vengo viendo este tema de la inteligencia artificial involucrado en la programación. Hice un curso incluso de esto para entender de que va por dentro en su funcionamiento.

Entonces bien, le pedi que me arme un script en bash que ejecute las instrucciones que solia ejecutar, que pida los numero de version, que se fije que la version nueva sea mayor que la vieja, y que en cierto punto lo ejecute como root. Aca les paso el script que armó, y ejecuté con exito en mi servidor para pasar de la ultima version de la 29 a la 30.

Esta version que les paso fue despues de varios pedidos mejorando el script:


#!/bin/bash

# Verificar si se han pasado dos argumentos
if &#91; "$#" -ne 2 ]; then
    echo "Uso: $0 /version_nueva/ /version_vieja/"
    exit 1
fi

# Asignar las versiones a variables
version_nueva=$1
version_vieja=$2

# Mostrar la elección
echo "Has elegido la versión nueva: $version_nueva y la versión vieja: $version_vieja"

# Comparar las versiones
if &#91;&#91; "$version_nueva" > "$version_vieja" ]]; then
    echo "La versión nueva ($version_nueva) es mayor que la versión vieja ($version_vieja)."
else
    echo "Error: La versión nueva ($version_nueva) no es mayor que la versión vieja ($version_vieja)."
    exit 1
fi

# Ejecutar los comandos después de la comparación
echo "Comenzando la actualización a Nextcloud $version_nueva..."

# Paso 1: Cambiar a la carpeta de inicio
echo "Cambiando a la carpeta de inicio..."
cd ~

# Paso 2: Crear una carpeta para descomprimir
echo "Creando carpeta temporal para descomprimir..."
mkdir nextcloud_descomprimir
cd nextcloud_descomprimir

# Paso 3: Descargar el archivo de la nueva versión
echo "Descargando Nextcloud versión $version_nueva..."
wget "https://download.nextcloud.com/server/releases/nextcloud-$version_nueva.tar.bz2"

# Paso 4: Descomprimir el archivo
echo "Descomprimiendo el archivo descargado..."
tar xjf "nextcloud-$version_nueva.tar.bz2"

# Paso 5: Renombrar la carpeta extraída
echo "Renombrando la carpeta de Nextcloud a nextcloud-$version_nueva..."
mv nextcloud "nextcloud-$version_nueva"

# Paso 6: Mover la nueva versión a /var/www/html/
echo "Moviendo la nueva versión a /var/www/html/..."
sudo mv "nextcloud-$version_nueva" /var/www/html/

# Paso 7: Cambiar a la carpeta /var/www/html/
echo "Cambiando al directorio /var/www/html/..."
cd /var/www/html/

# Paso 8: Copiar el archivo de configuración de la versión anterior
echo "Copiando archivo de configuración de la versión $version_vieja..."
cp "nextcloud-$version_vieja/config/config.php" "nextcloud-$version_nueva/config/config.php"

# Paso 9: Cambiar los permisos de la nueva versión
echo "Cambiando los permisos de la nueva versión..."
sudo chown www-data:serg -Rf "nextcloud-$version_nueva"
sudo chmod 775 -Rf "nextcloud-$version_nueva"

# Paso 10: Crear una carpeta de backup para la configuración de la versión vieja
echo "Creando carpeta de respaldo para la configuración de la versión $version_vieja..."
cd ~
mkdir -p "backup/nextcloud/$version_vieja"
cd "backup/nextcloud/$version_vieja"

# Paso 11: Copiar la configuración de la versión vieja al backup
echo "Realizando copia de seguridad del archivo de configuración de la versión $version_vieja..."
cp -Rf "/var/www/html/nextcloud-$version_vieja/config" ./

# Paso 12: Realizar backup de la base de datos usando mysqldump como root
echo "Realizando backup de la base de datos de Nextcloud versión $version_vieja..."
sudo bash -c 'mysqldump -uroot -p..1323 nextcloud --default-character-set=utf8mb4 | gzip -9 > ./nextcloud-'$version_vieja'.sql.gz'

# Paso 13: Poner Nextcloud en modo mantenimiento
echo "Poniendo Nextcloud $version_vieja en modo mantenimiento..."
cd "/var/www/html/nextcloud-$version_vieja"
sudo -u www-data php occ maintenance:mode --on

# Paso 14: Editar configuración de Apache para la nueva versión
echo "Editando la configuración de Apache para la nueva versión..."
sudo vim /etc/apache2/sites-available/cloud.conf   # Cambiar el directorio a la nueva versión
sudo vim /etc/apache2/sites-available/cloud-le-ssl.conf  # Cambiar el directorio a la nueva versión

# Paso 15: Reiniciar el servicio de Apache
echo "Reiniciando Apache..."
sudo service apache2 restart

# Paso 16: Editar archivo de configuración de Nextcloud
echo "Actualizando el archivo de configuración de Nextcloud con la nueva versión..."
sudo vim "/var/www/html/nextcloud-$version_nueva/config/config.php"   # Cambiar la versión en el parámetro

# Paso 17: Ejecutar la actualización de Nextcloud
echo "Ejecutando la actualización de Nextcloud a la versión $version_nueva..."
cd "/var/www/html/nextcloud-$version_nueva"
sudo -u www-data php occ upgrade

# Paso 18: Escanear los archivos del usuario serg
echo "Escaneando los archivos del usuario serg..."
sudo -u www-data php console.php files:scan serg

echo "Proceso de actualización completado para Nextcloud $version_nueva."

Enjoy!

Dar internet cuando tu VPN no te lo permite

Manejo de la tabla de route windows / linux

Mi Mujer tenia que conectarse a su trabajo por VPN, el caso interesante fue que al conectarse a la VPN perdía la conexión a Internet. En este caso el analisis fue en windows, pero la solucion podria haberse hecho tranquilamente en linux.

El problema aquí es que hay 2 rutas en la tabla de routeo que hacen de gateway de «salida a internet»

la tabla de routeo tiene algo que se llama Métrica que cuanto menor es, mas «preferible» es para usar por el sistema.

Entonces lo que tenía que hacer era básicamente eliminar la ruta que hacia de «salida» a Internet por la interfaz 172.16.1.183 (la VPN)


route delete 0.0.0.0 mask 0.0.0.0 0.0.0.0

Pero para acceder a las «rutas» que mi mujer necesitaba para trabajar, habia que agregarlas a mano:


route add 192.1.2.74 mask 255.255.255.255 0.0.0.0 IF 24
route add 162.254.205.92 mask 255.255.255.255 0.0.0.0 IF 24

la pregunta es : porque puse como «gateway» el 0.0.0.0 ? y el IF (interface) porque puse el 24 ?

Para responder a la primera pregunta, el 0.0.0.0 en windows se pone así para indicar que sea una ruta ONLINK tal como estaba la ruta de gateway de «salida» a internet por la VPN

La segunda es simplemente ver la salida del route print de windows para ubicar la interfaz correcta (la interfaz que se crea on the fly cada vez que se conecta)

claramente la interfaz «BALAT VPN» es la que quiero, por eso puse el numero 24 en la parte de interfaz

y listo ! con esto, devolvemos internet a la maquina pudiendo conectar a a la VPN sin problemas !

en windows como en linux se puede hacer un script para que se ejecuten estos commandos

en windows simplemente ponemos lo sig. en un archivo .BAT y lo ejecutamos como administrador, luego de cada conexión a la VPN


echo off
route delete 0.0.0.0 mask 0.0.0.0 0.0.0.0
route add 192.1.2.74 mask 255.255.255.255 0.0.0.0 IF 24
route add 162.254.205.92 mask 255.255.255.255 0.0.0.0 IF 24
echo on
echo 'complete'

Algunas notas de la tabla de ROUTE:

1.- se lee de abajo hacia arriba

2.- si hay 2 rutas que indican lo mismo, gana la de menor metrica

Mysql / MariaDb: trabajar con fechas sin contar con los finnes de semana

bueno luego de batallar bastante rato, como siempre escribo algo al respecto, me toca trabajar con la base de datos Mysql / MariaDb y manejar calendario de dias hábiles (es decir sin contar los finde de semana), intenté ver sin con una querie se podía resolver, llegué a la conclusión que no hay otra manera de hacer una funcion de Mysql que me maneje ese tema (ni a palos lo pongo en el codigo del sistema) el problema es que hay que siempre mantener actualziada la funcion en todos los ambientes donde se trabaja, y eso es un problema

Pero al menor de los males vamos, la necesidad lleva a hacer estas cosas que el motor por si solo no puede resolver

Aqui les comparto el codigo de la funcion, la funcion la oriente a lo que necesitaba, tomo un fecha inicial y quiero saber cual es la fecha resultante luego de sumarle X dias habiles, interesante no ?


DELIMITER $$

DROP FUNCTION IF EXISTS `mm`.`AddWeekDays`$$

CREATE FUNCTION `AddWeekDays`(sdate VARCHAR(50), days INT) RETURNS DATE
BEGIN
  DECLARE wdays, tdiff, counter, thisday SMALLINT;
  DECLARE newdate DATE;
  SET newdate := sdate;
  SET wdays = 1;
  IF days = 0 THEN RETURN newdate; END IF;
  label1: LOOP
    SET thisday = DAYOFWEEK(newdate);

    IF thisday BETWEEN 1 AND 5 THEN SET newdate = DATE_ADD(newdate, INTERVAL 1 DAY);  END IF;
    IF thisday = 6 THEN SET newdate = DATE_ADD(newdate, INTERVAL 3 DAY); END IF;
    IF thisday = 7 THEN SET newdate = DATE_ADD(newdate, INTERVAL 2 DAY); END IF;
   
   
    IF thisday BETWEEN 2 AND 6 THEN SET wdays:= wdays +1; END IF;
   
    IF wdays > days THEN LEAVE label1; END IF;
  END LOOP label1;
  RETURN newdate;
END$$

DELIMITER ;

svn error E000022 invalid UTF-8 sequence

Hace poco me paso que necesitaba actualizar un repo SVN con

$ sudo svn up

Con lo cual me encuentro que no es posible, por el siguiente error:

svn: E000022: Error converting entry in directory '/var/www/html/sigp-ag/upload/cp' to UTF-8
svn: E000022: Valid UTF-8 data
(hex: 31 34 38 37 38 38 35 35 35 35 2d 48 68 31 35 65 2d 43 75)
followed by invalid UTF-8 sequence
(hex: c3 2e 64 6f)

La unica forma de lograr update del repo era ir directorio por directorio de los que YO sabia que habia cambios haciendo svn up
Obviamente no es nada practico, el problema es que el SVN de que se trata el error ni siquiera de donde proviene…

Mi compañero de trabajo me decia, «si ! es molesto hacer así svn up por cada directorio que uno sabe que hay cambios, pero intenté arreglarlo y no pude»

Así que me dispuse a resolverlo, googleando mucho, veo que no hay mucha información, y nadie termina por resolver el problema, encontrando diferentes notas de personas que se encontraron el error, pude encontrar la forma de identificar el probleme y resolverlo !

Primero que nada, el problema viene de una codificación no estandar al sistema operativo (en mi caso está por default el encodign UTF 8), y la codificación no standard que encuentra el SVN obviamente se encuentra en alguno de los archivos del directorio que denuncia, en mi caso:

/var/www/html/sigp-ag/upload/cp

el problema no tiene nada que ver con el encoding del contenido del archivo, sino del nombre del archivo que tiene una codificación invalida para UTF 8

La forma de detectar cual es el archivo que tiene el problema es haciendo:

$ echo "\x31\x34\x38\x37\x38\x38\x35\x35\x35\x35\x2d\x48\x68\x31\x35\x65\x2d\x43\x75\xc3\x2e\x64\x6f" | xargs -0 printf

En mi caso lo unico que hice fue anteponer \x en cada numero empezando por la secuencia que es valida para SVN y a continuación por la invalida según SVN:

1487885555-Hh15e-Cu�.do

Ese es el archivo en mi caso que trae problemas: aqui hay 2 posibilidades, 1 borrar el archivo (la facil), 2 cambiar el encodig del nombre del archivo que está trayendo problemas…

Yo lo que hice fue, eliminar el archivo del versionado, directamente todo el directorio lo saque del versionado, y listo

Upgrade Nextcloud 28 a 29 (funciona entre cuales quiera versión que las haya aplicado)

Luego de ejecutar el actualizador automatico de nextcloud dentro de la versión 28, me pareció bien y util.

Ayer u antes de ayer, apareció una release mayor 29, donde publicaban mejoras de rendimiento y otras cosas importantes

Por lo que me propuse actualizar «a mano» la versión que tenía instalado en mi vps

Les comparto las instrucciones que me llevaron al éxito de la actualización y me han servido entre varias versiónes entre las que tuve que actualizar el producto…, de hecho las instrucciones me han quedado con versiones entre las que actualizaba cuando tenía owncloud ! jajaja

cd
mkdir nextcloud_descomprimir
cd nextcloud_descomprimir
wget https://download.nextcloud.com/server/releases/nextcloud-29.0.7.tar.bz2
tar xjf nextcloud-29.0.7.tar.bz2
mv nextcloud nextcloud-29.0.7
sudo mv nextcloud-29.0.7 /var/www/html/
cd /var/www/html/
cp nextcloud-28.0.10/config/config.php nextcloud-29.0.7/config/config.php
sudo chown www-data:serg -Rf nextcloud-29.0.7
sudo chmod 775 -Rf nextcloud-29.0.7
cd
mkdir backup/nextcloud/28.0.10
cd backup/nextcloud/28.0.10
cp -Rf /var/www/html/nextcloud-28.0.10/config ./
mysqldump -uroot -p..1323 nextcloud --default-character-set=utf8mb4 | gzip -9 &gt; ./nextcloud-28.0.10.sql.gz

cd /var/www/html/nextcloud-28.0.10
sudo -u www-data php occ maintenance:mode --on
sudo vim /etc/apache2/sites-available/cloud.conf # cambiar el directorio con la nueva versión
sudo vim /etc/apache2/sites-available/cloud-le-ssl.conf # cambiar el directorio con la nueva versión
sudo service apache2 restart
sudo vim /var/www/html/nextcloud-29.0.7/config/config.php # cambiar la version en el parametro

cd /var/www/html/nextcloud-29.0.7
sudo -u www-data php occ upgrade

sudo -u www-data php console.php files:scan NombreUsuarioQueTieneMuchosArchivos

Seguir leyendo Upgrade Nextcloud 28 a 29 (funciona entre cuales quiera versión que las haya aplicado) →

Consultar API REST desde oracle 11g

Me toca investigar un tema relativamente interesante:

Como invocar una API REST via POST para comunicar novedades de los cambios que vayan sufriendo las tablas de una base de datos Oracle 11g via trigger y stored procedure:

En la recopilación, me encontrado como siempre la información fragmentada y confusa. Lo que pretendo con este articulo es clarificar los pasos a seguir sin vueltas:

a trabajar !


— Como Sysdba de la DB creamos un usuario común que ejecutará las consultas a la DB que dispararán el trigger que generará por via de un Stored procedure una call a la API REST via POST con parámetros por su puesto.

— Como sysdba:

set serveroutput on;
exec dbms_output.enable(1000000000);
set escape ‘\’

CREATE USER APIREST IDENTIFIED BY APIREST;
GRANT CREATE SESSION TO APIREST;
GRANT CREATE VIEW TO APIREST;
GRANT CREATE TABLE TO APIREST;
GRANT UNLIMITED TABLESPACE TO APIREST;
GRANT CREATE SEQUENCE TO APIREST;
GRANT create procedure TO APIREST;
GRANT create trigger to APIREST;

grant execute on utl_http to APIREST
grant execute on dbms_lock to APIREST

BEGIN
DBMS_NETWORK_ACL_ADMIN.create_acl (
acl => ‘local_sx_acl_file.xml’,
description => ‘A test of the ACL functionality’,
principal => ‘APIREST’,
is_grant => TRUE,
privilege => ‘connect’,
start_date => SYSTIMESTAMP,
end_date => NULL);
COMMIT;
end;
/

begin
DBMS_NETWORK_ACL_ADMIN.assign_acl (
acl => ‘local_sx_acl_file.xml’,
host => ‘10.9.4.99’,
lower_port => 8161,
upper_port => NULL);
COMMIT;
end;
/

— LOGIN CON APIREST
— Usando la funcionalidad

create or replace
procedure consult_service_rest is
req UTL_HTTP.REQ;
resp UTL_HTTP.RESP;
value VARCHAR2(1024); — URL to post to
v_url VARCHAR2(200) := ‘http://10.9.4.99:8161/api/message/queue-pruebaa?type=queue’;
— Post Parameters
v_param VARCHAR2(500) := ‘body=hola_mundooo’;
v_param_length NUMBER := length(v_param);
BEGIN

req := UTL_HTTP.BEGIN_REQUEST (url=> v_url, method => ‘POST’);

— Use basic authentication if required.
UTL_HTTP.set_authentication(req, ‘sender’, ‘sender890’);

UTL_HTTP.SET_HEADER(req, ‘User-Agent’, ‘Mozilla/4.0’);

UTL_HTTP.SET_HEADER (r => req,
name => ‘Content-Type’,
value => ‘application/x-www-form-urlencoded’);
UTL_HTTP.SET_HEADER (r => req,
name => ‘Content-Length’,
value => v_param_length);
UTL_HTTP.WRITE_TEXT (r => req,
data => v_param);

resp := UTL_HTTP.GET_RESPONSE(req);

LOOP
UTL_HTTP.READ_LINE(resp, value, TRUE);
DBMS_OUTPUT.PUT_LINE(value);
END LOOP;
UTL_HTTP.END_RESPONSE(resp);
EXCEPTION
WHEN UTL_HTTP.END_OF_BODY THEN
UTL_HTTP.END_RESPONSE(resp);
END;
/

— prueba invocando un HTTP request directamente

begin
consult_service_rest;
end;
/

SEGUNDA PARTE: Trigger que antes de insert en una tabla invoque el Store consult_service_rest;

create table t (
x int
);

create or replace function f (p int)
return int as
begin
return p + 1;
end;
/

create or replace procedure p (p int) is
begin
dbms_output.put_line(‘Input = ‘ || p);
end p;
/

create or replace trigger trig
before insert on t FOR EACH ROW
declare
l int;
begin
l := f(:NEW.x);
p(l);
consult_service_rest;
end;
/

SQL> set serveroutput on
SQL> insert into t values (1);
Input = 2

Message Sent


Problemas que surgieron sobre la marcha:

A.– Ver si la ACL está bien establecida

http://dba-oracle.com/t_ora_24247_network_access_denied_by_access_control_list_tips.htm
select utl_http.request(‘http://10.9.4.199:8080/alfresco/faces/jsp/dashboards/container.jsp’) from dual;


B.- Certificado invalidos y no importados a wallet de oracle

http://blog.whitehorses.nl/2010/05/27/access-to-https-via-utl_http-using-the-orapki-wallet-command/
1.- con firefox, exportar en el x.509 Certificate PEM cada uno de los certificados desde el propio sitio hasta la autoridad certificante
2.- mkdir /home/oracle/wallet
3. -orapki wallet create -wallet /home/oracle/wallet -pwd password123 -auto_login
4.- scp los archivos de certificados a esa ruta del wallet
5.- agregar los certificados DESDE la CA hasta el propio sitio (al revez de como lo exportaste)
$ orapki wallet add -wallet /home/oracle/wallet -trusted_cert -cert COMODORSACertificationAuthority.crt -pwd password123
$ orapki wallet add -wallet /home/oracle/wallet -trusted_cert -cert COMODORSAOrganizationValidationSecureServerCA.crt -pwd password123
$ orapki wallet add -wallet /home/oracle/wallet -trusted_cert -cert gcbagobar.crt -pwd password123
6.- Comprobar que se hayan importado:
orapki wallet display -wallet /home/oracle/wallet -pwd password123

7.- Ahora a usarlo:

select utl_http.request(‘https://esb.gcba.gob.ar/infomet/historico/20171212′, NULL,’file:/home/oracle/wallet’,’password123′) from dual;

instalar filezilla ultima versión en Xential ubuntu 16.04

Intentar utilizar el filezilla en ubuntu 16.04 recien instalado desde los repositorios oficiales, es basicamente la muerte, debido a que el programa hace Crash con solo usarlo despues de recien instalado

Lo que fui incursionando para poder resolver este tema, sería anecdótico contárselos en este articulo, por lo que voy a simplemente mostrar la forma de instalar y utilizar la ultima versión (que al momento de escribir esta entrada es la 3.30)

Pasos para instalar:

$ sudo apt purge filezilla # si ya lo tienen instalado

## Ir al navegador y descargar el cliente desde el sitio oficial https://filezilla-project.org/download.php

en mi caso obtuvo el archivo: FileZilla_3.30.0_x86_64-linux-gnu.tar.bz2, sigamos con los pasos

$ tar xjf FileZilla_3.30.0_x86_64-linux-gnu.tar.bz2
$ sudo cp Filezilla3 /usr/local/bin/filezilla-folder
$ sudo ln -s /usr/local/bin/filezilla-folder/bin/filezilla /usr/local/bin/filezilla  # con esto es accesible desde cualquier ubicacion que estemos en el filesystem

Listo ! ya lo deberíamos tener listo

$ filezilla

Problemas:
Me a ocurrido que me dice:

filezilla: /usr/lib/x86_64-linux-gnu/libstdc++.so.6: version `GLIBCXX_3.4.22' not found (required by ./filezilla)

revisando:…

$ strings /usr/lib/x86_64-linux-gnu/libstdc++.so.6 | grep GLIBCXX
GLIBCXX_3.4
GLIBCXX_3.4.1
GLIBCXX_3.4.2
GLIBCXX_3.4.3
GLIBCXX_3.4.4
GLIBCXX_3.4.5
GLIBCXX_3.4.6
GLIBCXX_3.4.7
GLIBCXX_3.4.8
GLIBCXX_3.4.9
GLIBCXX_3.4.10
GLIBCXX_3.4.11
GLIBCXX_3.4.12
GLIBCXX_3.4.13
GLIBCXX_3.4.14
GLIBCXX_3.4.15
GLIBCXX_3.4.16
GLIBCXX_3.4.17
GLIBCXX_3.4.18
GLIBCXX_3.4.19
GLIBCXX_3.4.20
GLIBCXX_3.4.21
GLIBCXX_DEBUG_MESSAGE_LENGTH

Que mala suerte ! el filezilla pide justo una versión más de la ultima que tenemos disponible en el systema

Vemos como lo solucionamos:

$ sudo add-apt-repository ppa:ubuntu-toolchain-r/test

$ sudo apt-get update

Tiró error: W: An error occurred during the signature verification. The repository is not updated and the previous index files will be used. GPG error: http://screenshots.getdeb.net xenial-getdeb InRelease: The following signatures couldn't be verified because the public key is not available: NO_PUBKEY A8A515F046D7E7CF
W: Failed to fetch http://archive.getdeb.net/ubuntu/dists/xenial-getdeb/InRelease  The following signatures couldn'
t be verified because the public key is not available: NO_PUBKEY A8A515F046D7E7CF
W: Some index files failed to download. They have been ignored, or old ones used instead.


$ wget -q -O- http://archive.getdeb.net/getdeb-archive.key | sudo apt-key add -

$ sudo apt-key adv --keyserver keyserver.ubuntu.com --recv-keys A8A515F046D7E7CF
$ sudo apt-get update
$ sudo apt-get install gcc-6 g++-6
$ gcc-6 --version | head -n 2
gcc-6 (Ubuntu/Linaro 6.3.0-18ubuntu2~16.04) 6.3.0 20170519
Copyright (C) 2016 Free Software Foundation, Inc.

Ahora si ! tenemos disponible

$ strings /usr/lib/x86_64-linux-gnu/libstdc++.so.6 | grep GLIBCXX
GLIBCXX_3.4
GLIBCXX_3.4.1
GLIBCXX_3.4.2
GLIBCXX_3.4.3
GLIBCXX_3.4.4
GLIBCXX_3.4.5
GLIBCXX_3.4.6
GLIBCXX_3.4.7
GLIBCXX_3.4.8
GLIBCXX_3.4.9
GLIBCXX_3.4.10
GLIBCXX_3.4.11
GLIBCXX_3.4.12
GLIBCXX_3.4.13
GLIBCXX_3.4.14
GLIBCXX_3.4.15
GLIBCXX_3.4.16
GLIBCXX_3.4.17
GLIBCXX_3.4.18
GLIBCXX_3.4.19
GLIBCXX_3.4.20
GLIBCXX_3.4.21
GLIBCXX_3.4.22
GLIBCXX_3.4.23
GLIBCXX_3.4.24
GLIBCXX_DEBUG_MESSAGE_LENGTH

Con esto podremos ejecutar y tener instalado el filezilla ultima versión

Gracias por leer !

Saludos
PegasusOnline

Notas y vivencias sobre un teclado